Ciências Sociais em Diálogo
Análises Descritivas Multivariadas
Análise de correlações entre engajamento e origem do tráfego
- O que é engajamento ?
- Qual sua relevância ?
- Como é calculado ?
- Como os não inscritos acessam ?
Conceito relacionado ao empenho dos inscritos em consumir conteúdos do canal e também uma estratégia de estimular o interesse deles em conhecer, comentar e compartilhar sobre o seu conteúdo.
Também se refere à forma como o público interage com o conteúdo de um canal, como por meio de comentários, curtidas, compartilhamentos, entre outras ações
As pegadas digitais, comentários e seus metadados são recursos relevantes para os algoritmos dos buscadores e os novos recursos de IA generativa (Perplexity, GPTs, Genesis). O usuário inscrito pode influenciar positivamente outros usuários ao promover o conteúdo do canal e atrair novos inscritos, realimentando o engajamento.
O cálculo, geralmente, é realizado a partir da divisão entre o número de interações (curtidas, descurtidas e comentários) pelo número de seguidores, e o resultado multiplicado por 1.000, segundo métrica indicada pelo Buzzmonitor, utilizando dados fornecidos pelo Youtube.
Os não inscritos, em sua maioria, acessam por recomendações na barra lateral e sugestões ao final de outras reproduções, então é recomendável promover outros vídeos do canal na tela final, inserir marca d’água para fixar logotipo do canal, moderar e responder todos os comentários e fornecer uma boa descrição de cada conteúdo e do canal.
Origem de tráfego x Visualizações X Tempo de exibição
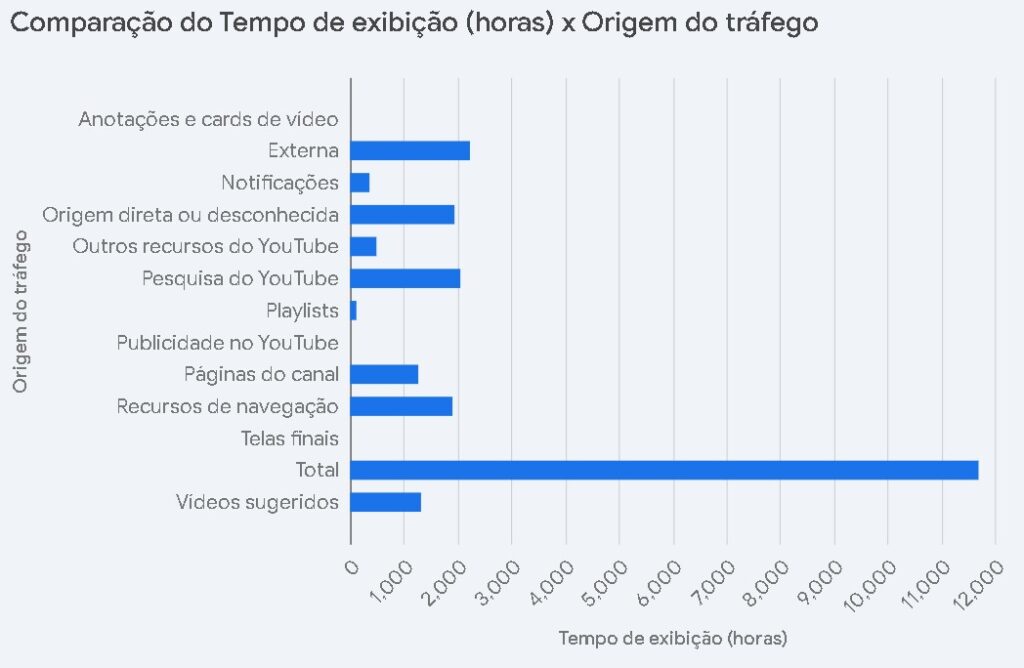
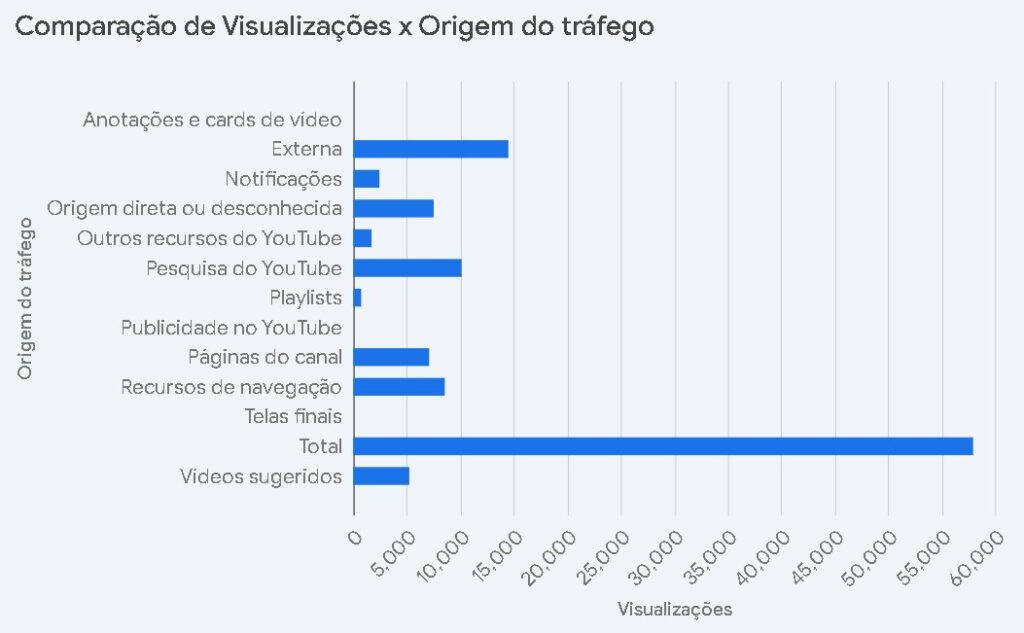
- Análise de correlações
- método ANOVA bidirecional
- Influência nas visualizações
- Regressão Logística se aplica?
Ao analisarmos os dados correlacionando as variáveis de visualizações às diferentes origens do tráfego e se o usuário é inscrito ou não, podemos adequar um modelo de regressão pelo fato da variável “Visualizações” não ser categórica e inconstante ao longo do tempo.
Nesse caso é viável utilizar um modelo de regressão linear para correlacionar as variáveis ”Origem do tráfego” e “Status da inscrição” à variável “Visualizações”.
Inicialmente podemos aplicar o método ANOVA bidirecional (LARS & WOLD, 1989), usado quando há uma variável quantitativa e duas variáveis nominais. Ele permite investigar o efeito simultâneo de duas variáveis independentes na variável dependente, sendo que o teste F para a não normalidade (análise de variações) foi estudada desde a década de 1930, produzindo resultados polêmicos com evidências a favor e contra sua robustez (BLANCA MENA, 2017).
O teste consiste em analisar as diferenças entre as médias das “Visualizações” para cada categoria de “Origem de Tráfego e “Tempo de Exibição”.
As análises ANOVA indicaram diferenças significativas nas médias de Visualizações entre as diferentes categorias:
Os resultados da análise descritiva, da regressão linear e dos dados articulados sugerem que as variáveis “Origem do tráfego” e “Status da Inscrição” exercem uma influência significativa em “Visualizações”. Entretanto, é essencial notar que a distribuição de “Visualizações” não é normal, o que pode limitar a adequação de um modelo de regressão linear.
Origem Tráfego: F-statistic = 79,25 e p-value = 0,000
Status da Inscrição: F-statistic = 90,76 e p-value = 0,000
Seria inviável empregar regressão logística para analisar as correlações entre as colunas das tabelas, pois a regressão logística é utilizada para predizer uma variável de resultado categórica, tipicamente binária (0 ou 1), e a variável “Visualizações” é uma variável contínua.
Série temporal do modelo
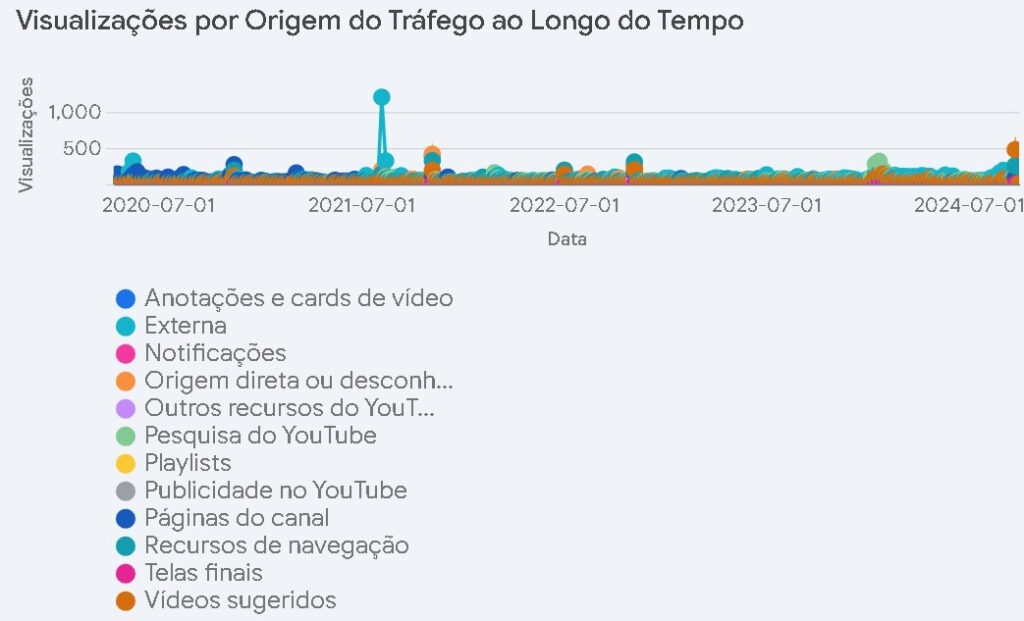
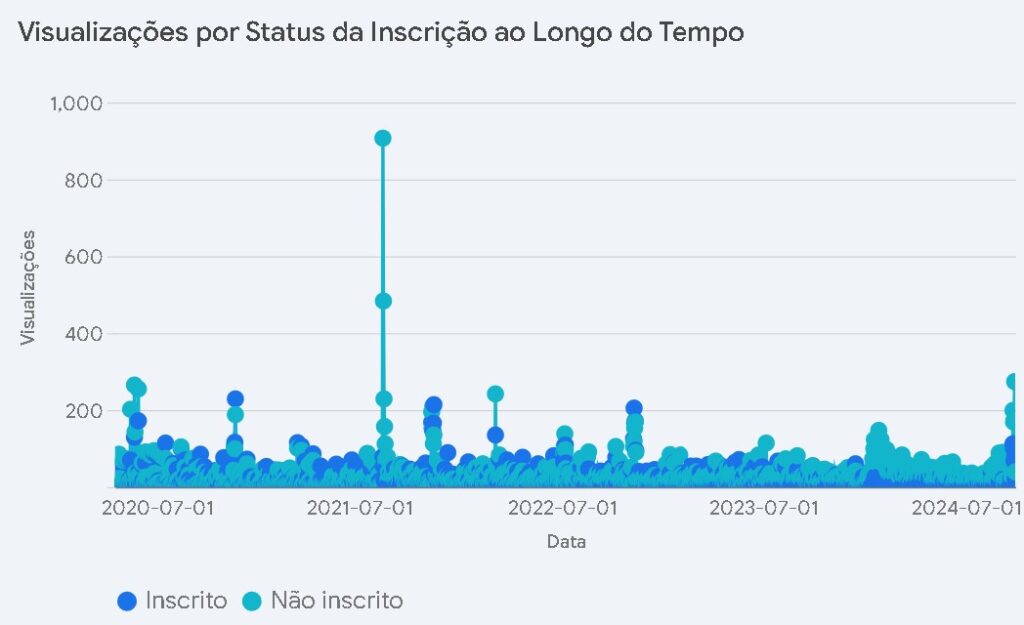
- R ao quadrado da Origem do Tráfego
- R ao quadrado do Status da Inscição
- Influência nas visualizações
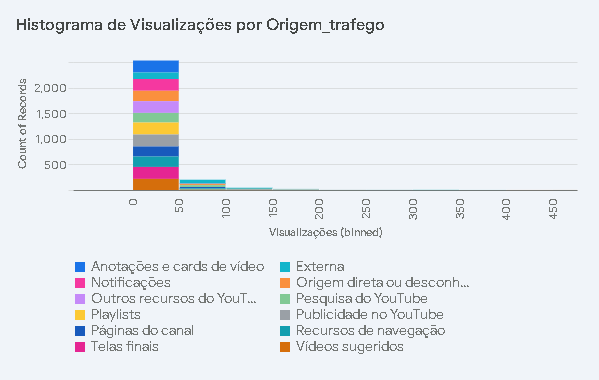
No gráfico por origem de tráfego, o valor de R ao quadrado de 0,495 indica que o modelo explica 49,5% da variância nas visualizações. Todos os níveis de origem do tráfego são preditores significativos de visualizações, exceto ‘Anotações e cards de vídeo’, ‘Playlists’, ‘Publicidade no YouTube’ e ‘Telas finais’, pois possuem valores de p superiores a 0,05.
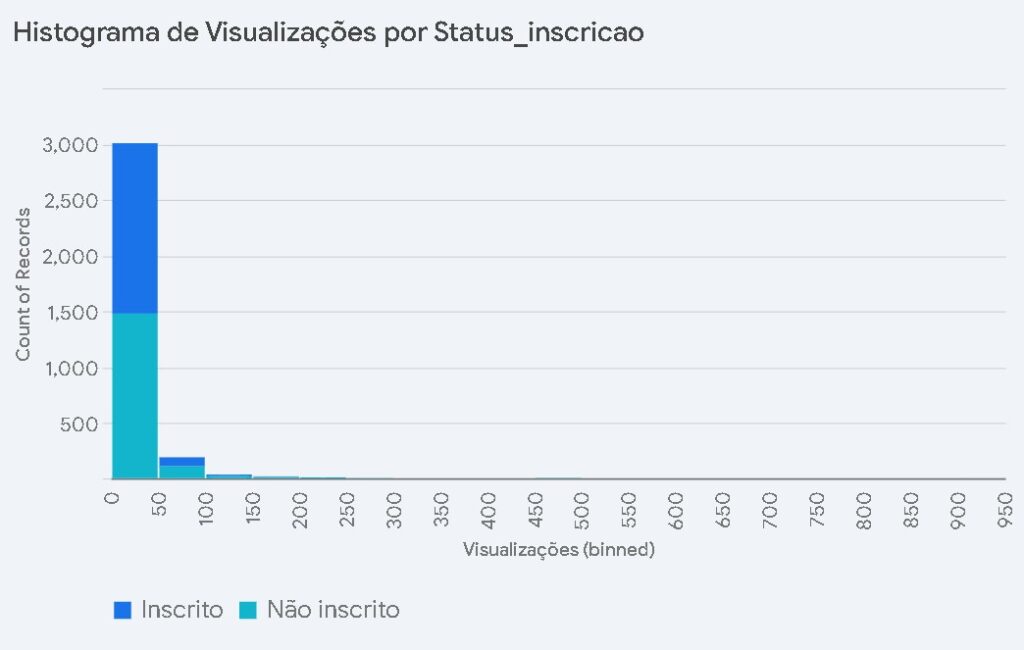
No gráfico Visualizações por status de inscrição, o valor de R ao quadrado de 0,311 indica que o modelo explica 31,1% da variância nas visualizações. Ambos os níveis de status de inscrição são preditores significativos de visualizações, com valores de p inferiores a 0,05.
Os campos “Origem do Tráfego” e “Status da Inscrição” influenciam a variável “Visualizações”, que na média, varia de 0,00854701 para ‘Anotações e cards de vídeo’ a 61,9957 para ‘Origem Externa’, sendo um desvio padrão elevado para a maioria dos níveis de “Origem do Tráfego”, indicando extensa variação nos dados.
Análise por histograma
- Média de Visualizações e Desvio Padrão
- Variância dos modelos
- Valores não significativos
Em relação à média de “Visualizações”, os ‘Inscritos’ somam 12,7177 e de 22,8887 para ‘Não inscritos’, sendo um desvio padrão também elevado, sugerindo alta variabilidade para o “Status da Inscrição”:
O modelo para “Origem do Tráfego” explica 49,5% da variância em “Visualizações” e o modelo para “Status da Inscrição” explica 31,1% da mesma variância.
“Anotações e cards de vídeo”, “Playlists”, “Publicidade no YouTube” e “Telas finais” têm valores-p maiores que 0,05, indicando que não são estatisticamente significativos.
Inferência
Pode-se inferir que nem todos os níveis de “Origem de Tráfego" são preditores significativos de “Visualizações”.
Os histogramas também demonstram que a variável “Visualizações” não segue uma distribuição normal e regressão linear não é a abordagem mais adequada.
Não é possível aplicar uma regressão logística para analisar as correlações entre as colunas das tabelas fornecidas, pois a regressão logística é usada para prever uma variável de resultado categórica e a variável “Visualizações” é uma variável contínua.