Rede de Apoio aos Professores de Língua Estrangeira
Análises de Conteúdos
Análises e Resumos por modelos de IA: Gemini Advanced e MAXQDA
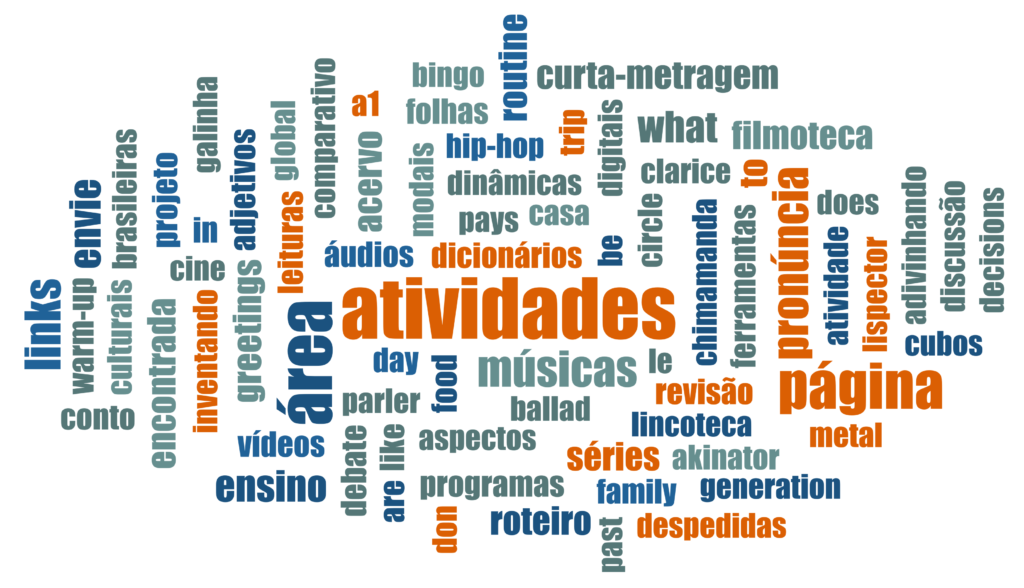
Nuvem de palavras do site da RAPLE
Nuvem de palavras do site da RAPLE
Tendência de palavras no site da Raple
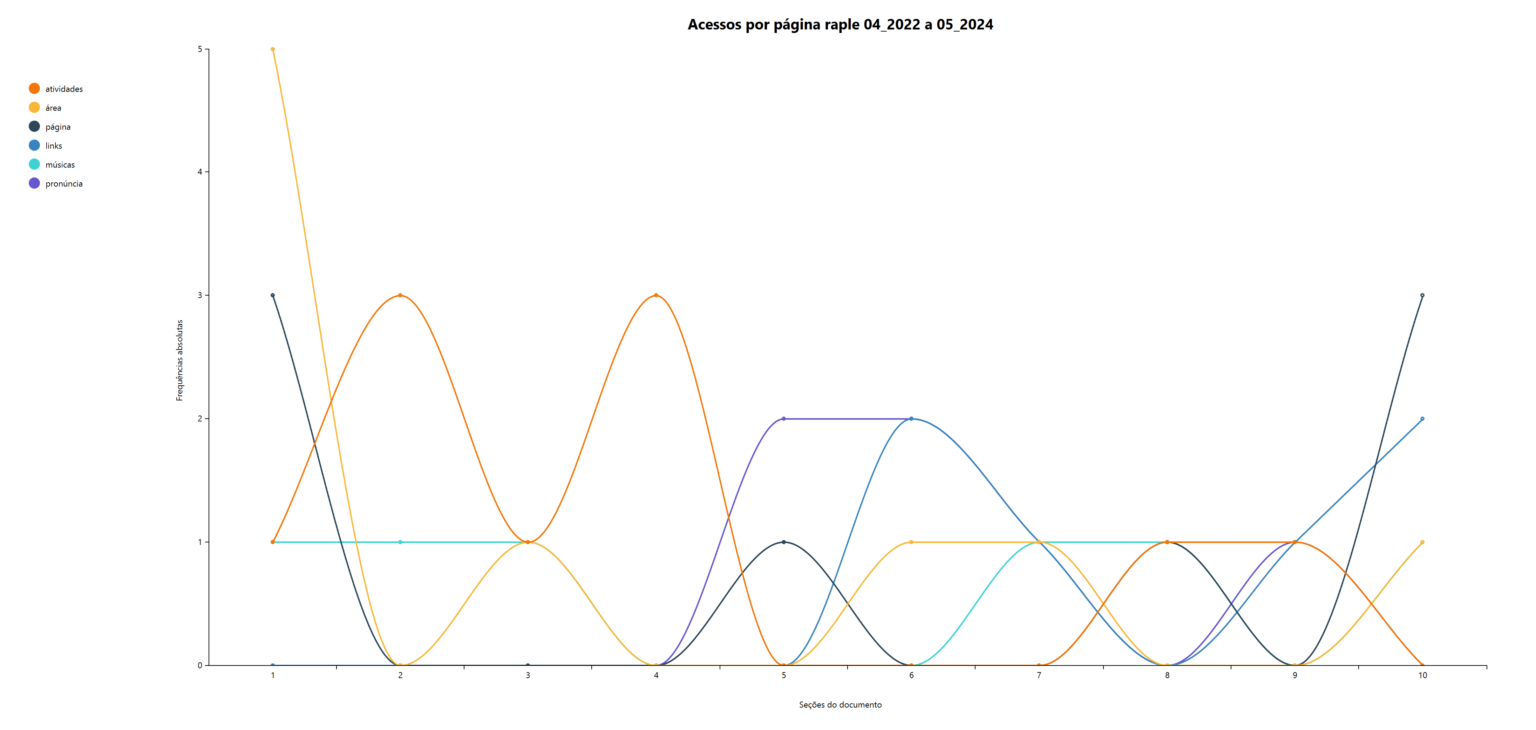
Análise de Dados da planilha de acessos
Geração de código em Python
- Quais os principais assuntos do site ?
- Código em Python
- Saída do código
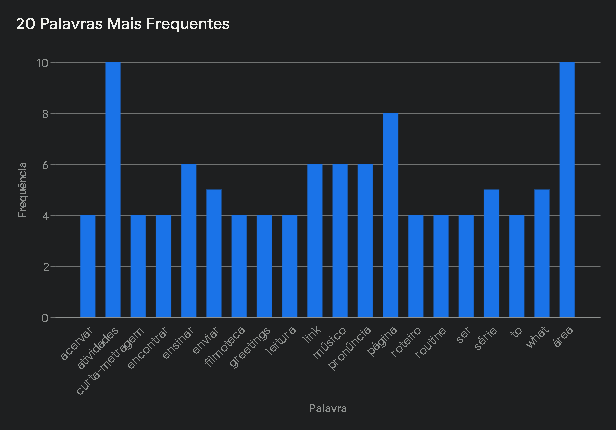
Para identificar os assuntos sobre os quais os registros tratam, vamos analisar as palavras mais frequentes encontradas no site. A coluna Palavra contém essas palavras, e a coluna Frequência indica a frequência com que cada palavra aparece. Vamos ordenar as palavras por frequência em ordem decrescente e exibir as 20 primeiras para ter uma visão geral dos assuntos mais abordados.
Analisando as 20 palavras mais frequentes, podemos identificar alguns assuntos que parecem ser o foco dos registros:
- Educação/Aprendizado: Palavras como ‘ensinar’, ‘leitura’, ‘pronúncia’ e ‘série’ sugerem que o site pode conter materiais ou recursos educacionais, possivelmente relacionados ao ensino de idiomas ou música (‘músico’).
- Cinema: As palavras ‘filmoteca’ e ‘curta-metragem’ indicam que pode haver conteúdo relacionado a filmes, talvez com foco em curtas-metragens.
- Website/Navegação: Termos como ‘página’, ‘link’ e ‘enviar’ são comuns em sites e podem estar relacionados à estrutura e navegação do próprio site.
- Inglês: A presença da palavra ‘what’ e da preposição ‘to’ sugere que parte do conteúdo pode estar em inglês ou ser voltado para o aprendizado da língua inglesa.
- Rotina: A palavra ‘routine’ e ‘roteiro’ indica que o site pode oferecer dicas ou recursos para estabelecer rotinas, possivelmente relacionadas ao aprendizado ou desenvolvimento pessoal.
Observação: Essa análise é baseada em uma amostra limitada das palavras mais frequentes. Uma análise mais aprofundada de todo o conteúdo do site seria necessária para confirmar e expandir esses insights sobre os assuntos abordados.
Python
# Ordenar o DataFrame pela coluna 'Frequência' em ordem decrescente
df_sorted = df.sort_values(by='Frequência', ascending=False)

# Selecionar as 20 primeiras palavras do DataFrame ordenado
top_words = df_sorted['Palavra'].head(20)

# Imprimir as palavras mais frequentes
print("As 20 palavras mais frequentes são:\n")
print(top_words.to_list())
As 20 palavras mais frequentes são:

['área', 'atividades', 'página', 'ensinar', 'link', 'músico', 'pronúncia', 'enviar', 'série', 'what', 'leitura', 'to', 'ser', 'routine', 'roteiro', 'greetings', 'filmoteca', 'encontrar', 'curta-metragem', 'acervar']
Análise da amostra
Ao realizar uma análise mais aprofundada da amostra, explorando diferentes aspectos dos dados para obter insights adicionais sobre os assuntos abordados no site.
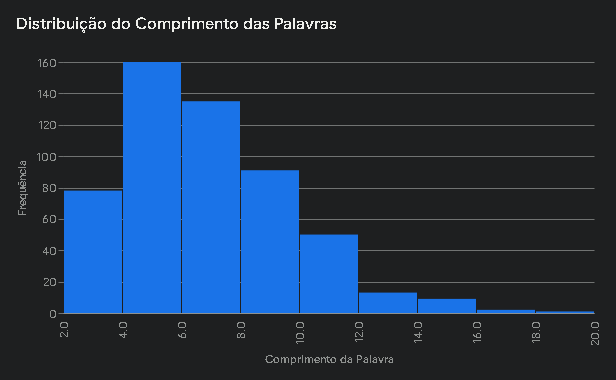
Primeiramente, vamos analisar a distribuição do comprimento das palavras. Isso pode nos dar uma ideia da complexidade do vocabulário utilizado no site e, indiretamente, do público-alvo. Em seguida, vamos visualizar a distribuição das frequências das palavras para entendermos melhor como as palavras se distribuem em termos de frequência de uso. Além disso, vamos criar um histograma para visualizar a distribuição dos comprimentos das palavras e um gráfico de barras para as palavras mais frequentes, o que facilitará a visualização e interpretação dos dados.
Estatísticas Descritivas:
- A média do comprimento das palavras é de 6.35 caracteres, com um desvio padrão de 2.85. Isso sugere uma variedade no tamanho das palavras utilizadas, com algumas palavras consideravelmente mais longas do que a média.
Distribuição do Comprimento das Palavras:
O histograma ‘Distribuição do Comprimento das Palavras’ revela que a maioria das palavras tem entre 4 e 8 caracteres, com um pico em torno de 6 caracteres. Palavras muito curtas (menos de 3 caracteres) ou muito longas (mais de 12 caracteres) são menos frequentes.
20 Palavras Mais Frequentes:
O gráfico de barras ’20 Palavras Mais Frequentes’ reforça a predominância de palavras relacionadas a educação, cinema e navegação no site, como já havíamos identificado anteriormente.
Conclusões Adicionais:
- A variedade no comprimento das palavras indica que o site pode ter conteúdo direcionado a diferentes níveis de conhecimento ou idade, com textos mais simples e outros com vocabulário mais complexo.
- A distribuição das frequências confirma que um número relativamente pequeno de palavras é responsável por grande parte do conteúdo do site, o que é comum em textos em geral.
- A análise das palavras mais frequentes, juntamente com a distribuição do comprimento das palavras, reforça a hipótese de que o site aborda temas relacionados a educação, cinema e possivelmente inglês, com conteúdo voltado tanto para iniciantes quanto para pessoas com conhecimento prévio nessas áreas.
Recomendações:
- Para uma análise ainda mais aprofundada, seria interessante analisar o contexto em que essas palavras são utilizadas, por meio de técnicas de processamento de linguagem natural, como a análise de bigramas ou trigramas (sequências de duas ou três palavras).
- A análise de outras métricas, como a riqueza lexical (número de palavras diferentes em relação ao total de palavras) e a frequência de palavras-chave específicas de cada área (por exemplo, termos técnicos de cinema ou música), também poderia fornecer insights adicionais sobre os assuntos abordados no site e seu público-alvo.
Codigo em Python de análise da amostra
import altair as alt

# 1. Calcular a média e o desvio padrão da coluna 'Comprimento da palavra'
mean_word_length = df['Comprimento da palavra'].mean()
std_word_length = df['Comprimento da palavra'].std()

# 2. Imprimir a média e o desvio padrão do comprimento das palavras
print(f'Média do comprimento das palavras: {mean_word_length:.2f}')
print(f'Desvio padrão do comprimento das palavras: {std_word_length:.2f}')

# 3. Criar um histograma da coluna 'Comprimento da palavra' com 10 bins
chart1 = alt.Chart(df).mark_bar().encode(
    x=alt.X('Comprimento da palavra:Q', bin=alt.Bin(maxbins=10), title='Comprimento da Palavra'),
    y=alt.Y('count()', title='Frequência'),
    tooltip = [alt.Tooltip('Comprimento da palavra:Q', bin=alt.Bin(maxbins=10), title='Comprimento da Palavra'), 'count()']
)

# 4. Adicionar o título 'Distribuição do Comprimento das Palavras' ao histograma
chart1 = chart1.properties(
    title='Distribuição do Comprimento das Palavras'
)

# 5. Adicionar a legenda 'Frequência' no eixo y e 'Comprimento da Palavra' no eixo x - Já feito na etapa 3

# 6. Exibir o histograma
chart1.save('distribuicao_comprimento_palavras_histograma.json')

# 7. Criar um gráfico de barras das 20 palavras mais frequentes
chart2 = alt.Chart(df_sorted.head(20)).mark_bar().encode(
    x=alt.X('Palavra:N', axis=alt.Axis(labelAngle=-45), title='Palavra'),
    y=alt.Y('Frequência:Q', title='Frequência'),
    tooltip = ['Palavra', 'Frequência']
)

# 8. Adicionar o título '20 Palavras Mais Frequentes' ao gráfico de barras
chart2 = chart2.properties(
    title='20 Palavras Mais Frequentes'
)

# 9. Adicionar a legenda 'Frequência' no eixo y e 'Palavra' no eixo x - Já feito na etapa 7

# 10. Rotacionar os rótulos do eixo x em 45 graus para melhor legibilidade - Já feito na etapa 7

# 11. Exibir o gráfico de barras
chart2.save('20_palavras_mais_frequentes_grafico_barras.json'
Qual a saída do código ?
Média do comprimento das palavras: 6.35
Desvio padrão do comprimento das palavras: 2.85